核心功能
-

 混合文档智能分类
-

 复杂场景高精度识别
-

 业务信息智能抽取
-

 批量处理能力

混合文档智能分类
可自动识别合同、发票、证件等全类型文档,支持自定义分类规则,批量上传即可自动归档,分类准确率超 98%

复杂场景高精度识别
兼容 PDF、扫描件、手写、印章、模糊、倾斜文档,支持中英数字混合识别,抗褶皱、低像素等干扰,文字识别准确率≥ 99%

业务信息智能抽取
自动识别并提取金额、证件号、日期等关键字段,输出结构化数据,可按需自定义抽取字段,适配各类业务表单

批量处理能力
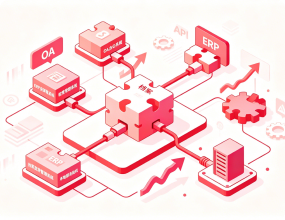
支持百万级文档批量并行处理,全程无需人工介入,分类、识别、抽取同步完成,可直接对接企业 OA、ERP、档案系统
智能分类
自动识别全类型文档,支持自定义分类规则,批量上传自动归档,准确率超 98%
高精度识别
兼容 PDF/扫描件/手写/印章/模糊/倾斜,中英数字混合识别,准确率 ≥ 99%
信息抽取
自动提取金额、证件号、日期等关键字段,输出结构化数据,支持自定义字段
批量处理
百万级文档并行处理,分类·识别·抽取同步完成,直接对接 OA/ERP/档案系统
方案优势
-
![]()
双模型融合技术领先
采用 OCR 识别 + 大模型语义理解双擎架构,兼顾文字识别精度与文档逻辑解析,突破传统单一识别工具能力瓶颈
-
![]()
大幅降本提质增效
批量处理效率提升 10 倍以上,文档处理人力成本降低 80%,处理时长由天级缩短至分钟级,解放人工重复劳动
-
![]()
数据精准安全可控
文档识别准确率超 99%,信息抽取错误率低于 1%,支持本地私有化部署,保障数据安全
-
![]()
部署对接灵活适配
支持本地私有化部署模式,标准化接口平滑对接 OA、ERP、档案管理等企业现有业务系统
技术通用
适配各类文档格式
免手动整理
泛化适应强
简单调整适配新场景
新业务灵活应对
运维成本低
无需开发训练
大幅降低各类成本
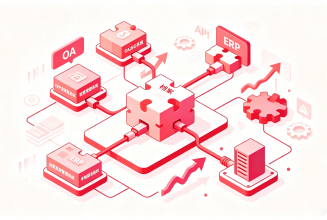
部署灵活
支持 API 与私有化部署
快速落地对接
落地场景
-


金融保险
批量处理保单、发票、借贷合同、客户身份证件等材料信息,自动提取金额、身份、期限等核心业务数据,支撑业务审核
-


政务办公
自动解析审批单、办事证件、申请材料,批量完成资料分类与信息提取,简化政务窗口纸质材料录入归档流程
-


企业人力法务办公
智能解析简历、入职表单、商事合同,自动抓取身份、薪资、条款信息,实现人事档案、法务合同自动化归档
-


档案数字化
面向存量纸质档案、历史扫描文件批量数字化,自动分类建档、提取关键索引,完成企业全量档案电子化管理
金融保险
政务办公
企业人力法务办公
档案数字化
合作客户
-
![]()
某股份制银行
自动批量解析保单、借贷合同、证件,提取金额期限数据,缩短信贷审核时效,保障金融数据本地安全。
-
![]()
大型能源央企
海量合同、票据、档案全自动分类抽取,百万文件并行处理,大幅减少档案录入人力成本。
-
![]()
上市制造业集团
单据、采购合同、资质文件智能结构化识别,无缝对接 ERP,提升供应链资料处理效率。

立即咨询

产品热线:
400-805-9676


 京公网安备11011402011670号